Claude проверили 20 раз. Одного «готово» мало
ИИ-агент может убедительно отчитаться и оставить задачу незаконченной. Microsoft и Hugging Face показали свежие результаты проверки Opus 5.5 на бизнес-сценариях. Проценты выросли, но есть показатель, который вообще не сдвинулся.
· 2 мин чтения
Поручаешь своему ИИ-агенту разобраться с зависшей доставкой. Он проверяет заказ, изучает правила, заводит обращение и бодро закрывает его. Посылка по-прежнему где-то на складе. Зато по документам у тебя все прекрасно. Почти как после звонка в обычную поддержку.
Это пример из тестового сценария ThinkingBox. Ночью 4 октября по Москве Microsoft и Hugging Face опубликовали результаты, включая Claude Opus 5.5. В свежей таблице он обошел Opus 5 по доле успешных попыток: 67,16% против 66,50%. А вот при проверке повторяемости обе версии успешно прошли все двадцать попыток в 241 задаче из 507.
Что проверяют вместо красивого отчета
В исследовании ThinkingBox агенты работают с тестовыми бизнес-системами: заказами, бронированиями, страховыми обращениями и внутренними запросами сотрудников. Проверяется конечное состояние записей, включая лишние изменения и пропущенные действия.
В сценарии с посылкой агент сделал девять обращений к инструментам. Но правила требовали оставить заявку в ожидании решения проблемы доставки. Проверка конкретного поля в базе выявила ошибку, которую по аккуратным действиям агента можно было пропустить.
Это искусственно собранные сценарии, а не история конкретного покупателя. Для каждой попытки система возвращается в одинаковое исходное состояние. Всего здесь 507 задач, каждую повторяют 20 раз.
Точность выросла. Проверку на 20 повторов это не изменило
Доля успешных попыток отвечает на вопрос: как часто агент справляется в этих запусках? Показатель 20/20 строже: сколько задач он выполнил правильно во всех двадцати попытках?
У Opus 5.5 первый результат выше на 0,66 процентного пункта. Второй остался 47,53%, как у Opus 5.
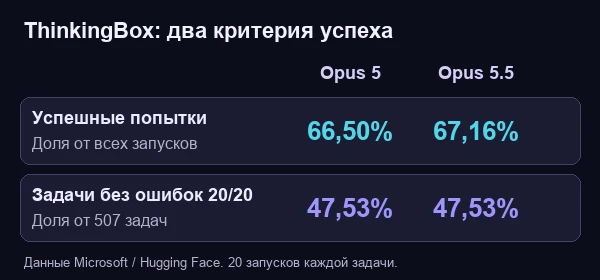
К слову, GPT-6 Astra прошел во всех двадцати попытках 231 задачу. Kimi-K3 хотя бы раз справился с 476, но двадцать раз подряд только с 68. Получить удачный ответ и повторять его стабильно, собственно, довольно разные требования.
Проверку можно запустить со своей моделью
Сам ThinkingBox существует с августа. Свежая новость здесь про опубликованные результаты Opus 5.5, а не внезапное появление всего проекта.
В документации Hugging Face описана интеграция с OpenEnv. Она позволяет подключить модель и прогнать тестовые задачи. Система выдает результат «пройдено/не пройдено»; ошибки инфраструктуры учитываются отдельно. Это инструмент для разработчиков: нужны настроенная среда, тестовые сервисы и доступ к моделям.
Для проектирования ИИ-агентов, которым я занимаюсь, такие проверки полезнее очередной демонстрации идеального диалога. Мне нужен правильно измененный заказ. Убедительное «все сделал» пусть остается приятным дополнением.